trilha de estudos · embeddings
Chatbots erram. A causa quase nunca é a que você imagina
Semana passada pesquisei os principais motivos de alucinação em sistemas de RAG (Retrieval-Augmented Generation) e percebi um erro comum: jogar a culpa na “IA que alucina”. Foi aí que percebi um buraco na minha própria base técnica. Resolvi voltar pro fundamento antes de seguir em frente.
O fundamento se chama embedding, e é provavelmente o conceito mais subestimado de quem trabalha com IA generativa.
O que é um embedding, na prática
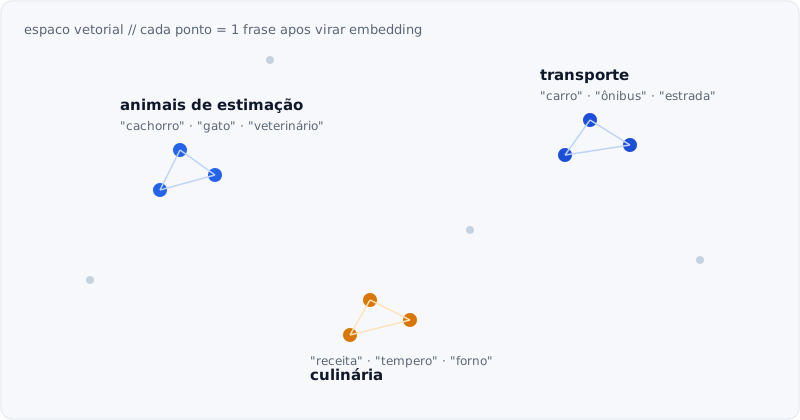
Todo texto que um modelo de linguagem processa é convertido em uma lista de números: um vetor. Esse vetor representa o significado do texto num espaço matemático. Textos com sentidos parecidos geram vetores que ficam próximos nesse espaço; textos de assuntos diferentes ficam distantes.
Isso parece abstrato, então pensa assim: é como se cada frase ganhasse uma “coordenada de GPS do significado”. “Cachorro” e “gato” caem num bairro parecido desse mapa. “Carro” e “estrada” caem em outro. É exatamente essa coordenada que permite buscar por significado, não por palavra exata.
Por que isso importa pra quem usa RAG
Um sistema de RAG não funciona porque “a IA é inteligente”. Funciona porque, por trás dele, existe uma busca vetorial comparando a pergunta do usuário com os documentos disponíveis, usando exatamente essa lógica de proximidade. Quando o sistema erra ou “alucina”, na maioria das vezes o problema não está no modelo de linguagem em si. Está na qualidade dessa busca: embeddings mal escolhidos, documentos mal divididos (chunking), ou contexto insuficiente chegando no prompt.
Entender embedding muda completamente como você debuga um problema de IA. Você para de tratar o sistema como caixa-preta e começa a saber exatamente onde olhar.
Aplicando na prática
Botei a mão na massa: gerei embeddings de frases de assuntos variados via API, calculei a similaridade entre elas e visualizei o resultado num gráfico 2D. Ver os agrupamentos se formarem, pets num canto, transporte em outro, culinária em outro, tornou um conceito abstrato em algo concreto e visual.
Esse exercício é o módulo 1 de uma trilha de estudos que estou construindo pra mim mesmo, focada em entender o que acontece por baixo de cada peça de um pipeline de RAG antes de aplicar isso em projetos maiores.
O código de exemplo do módulo 1, o script pronto que gera os embeddings, calcula a similaridade e desenha o gráfico, está no repositório estudo-llm-rag, pra quem quiser consultar ou rodar.
Pra quem está começando na área
Se você trabalha ou está estudando IA generativa e nunca parou pra entender embeddings de verdade, essa é a base que vale a pena revisitar. Não é sobre decorar a matemática por trás. É sobre entender o suficiente pra debugar com precisão, em vez de “tentar de novo e torcer”.
Bora trocar experiências? Se você também está nessa jornada de aprofundar os fundamentos de IA, comenta aqui: tô documentando cada módulo dessa trilha e adoraria ouvir o que outras pessoas estão descobrindo pelo caminho.
Pesquisando os motivos de alucinação em sistemas de RAG, quase culpei 'a IA que alucina'. O problema real estava em um fundamento que eu tinha pulado: embedding. Entender isso muda completamente como você debuga IA. 🧭
Nathan Amorim · nathanramorim.github.io